Pod 리소스만 바꿨을 뿐인데 GC가 변경되었다?!
limits cpu 8, mem 4Gi로 잘 돌던 Pod의 리소스를 limits cpu 1, mem 1Gi로 줄였다고 해보자.
resources:
  requests:
    cpu: "500m"
    memory: "1Gi"
  limits:
    cpu: "1"       # 8 → 1
    memory: "1Gi"  # 4Gi → 1Gi
JVM 옵션을 변경하지 않았는데, 재배포 후 JVM 지표를 보면 아래와 같이 바뀌어 있다.
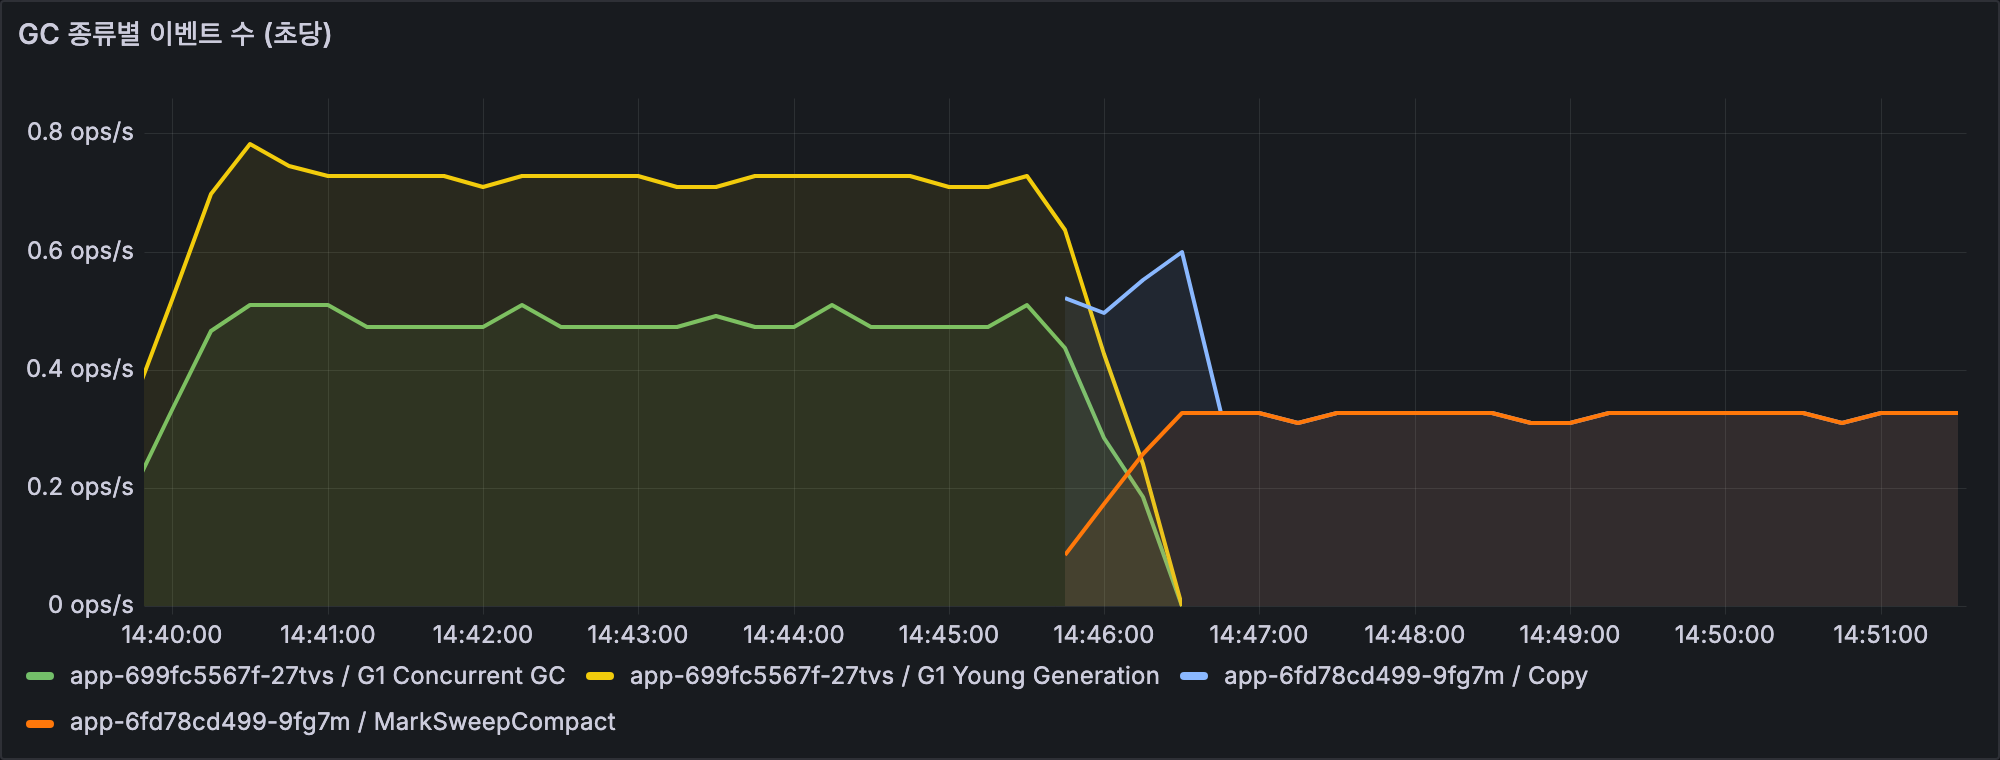
변경 후 Pod app-6fd78cd499-9fg7m (limits cpu 1, mem 1Gi) → Copy, MarkSweepCompact (두 값이 같아서 선이 겹쳐 보인다)
| 지표 | 변경 전 (limits cpu 8, mem 4Gi) | 변경 후 (limits cpu 1, mem 1Gi) |
|---|---|---|
jvm_gc_name | G1 Young Generation | Copy, MarkSweepCompact |
jvm_cpu_count | 8 | 1 |
최대 Heap (jvm_memory_limit_bytes) | 1024MiB | 247.5MiB |
GC가 G1에서 Serial로 바뀌었다. (Copy, MarkSweepCompact는 Serial GC의 Young, Old 수집기 이름이다.)
최대 Heap도 1/4로 줄었다. (-Xmx나 MaxRAMPercentage를 지정하지 않은 경우)
어디에도 -XX:+UseSerialGC를 쓴 적이 없는데 왜 이런 일이 생길까?
Q. JVM은 Pod 리소스로 뭘 정할까?
JVM은 GC 종류나 Heap 크기를 따로 지정하지 않으면 실행 환경을 보고 기본값을 정하는데, 이걸 ergonomics라고 한다.
컨테이너 안에서는 Kubernetes YAML이 아니라 Linux cgroup 파일(cgroup v2는 cpu.max, memory.max, v1은 cpu.cfs_quota_us, memory.limit_in_bytes)을 읽어서 자기에게 주어진 CPU와 메모리를 판단하는데, 이 동작을 켜는 옵션이 -XX:+UseContainerSupport다.
| 기능 | 들어간 버전 |
|---|---|
UseContainerSupport 기본 활성화 (cgroup v1) | JDK 10, 8u191 (JDK-8146115) |
| cgroup v2 인식 | JDK 15, 11.0.16, 8u372 (JDK-8230305) |
| CPU shares(requests)를 CPU 수 계산에서 제외 | 11.0.17, 17.0.5, 18.0.2 |
최근 Kubernetes 노드는 대부분 cgroup v2라서, 이보다 오래된 JDK는 limits 대신 노드 전체의 CPU와 메모리로 기본값을 정한다.
-XX:-UseContainerSupport로 컨테이너 인식을 꺼도 같은 일이 생기는데, limits cpu 1, mem 1Gi Pod에서 켜고 끈 결과를 비교하면 아래와 같다.
# 기본 (UseContainerSupport 켜짐)
[gc     ] Using Serial
[gc,init] CPUs: 10 total, 1 available
[gc,init] Memory: 1024M
[gc,init] Heap Max Capacity: 256M

# -XX:-UseContainerSupport
[gc     ] Using G1
[gc,init] CPUs: 10 total, 10 available
[gc,init] Memory: 7836M
[gc,init] Heap Max Capacity: 1960M
[gc,init] Parallel Workers: 9
컨테이너 인식을 끄면 노드의 CPU 10개와 메모리 7836M를 기준으로 계산하기 때문에, 최대 Heap이 1960M로 메모리 limit(1Gi)보다 커진다. Heap이 그만큼 차기 전에 컨테이너가 OOMKilled 될 수 있어서, 특별한 이유가 없다면 끄지 않는 게 맞다.
JVM이 컨테이너 리소스로 정하는 값은 아래 세 가지다.
| 자동으로 정해지는 값 | 기준 | 직접 지정하는 옵션 |
|---|---|---|
| 기본 GC 종류 | CPU 수 + 메모리 | -XX:+UseG1GC 등 |
| GC worker 수 | CPU 수 | -XX:ParallelGCThreads, -XX:ConcGCThreads |
| 최대 Heap | 메모리 × 25% | -Xmx, -XX:MaxRAMPercentage |
여기서 CPU와 메모리는 requests가 아니라 limits다.
cgroup v2 기준으로 CPU limit은 cpu.max의 quota/period로, 메모리 limit은 memory.max로 들어가고, requests는 스케줄링과 CPU 가중치에만 쓰인다.
- ex) limits cpu
500m과1은 둘 다 올림해서 CPU 1개로 인식되지만, 실제로 쓸 수 있는 CPU 시간은 두 배 차이가 난다 - ex) CPU limit을 걸지 않으면 quota가 없기 때문에, cpuset으로 CPU가 묶여 있지 않다면(예: kubelet CPU Manager static 정책이 아닌 경우) 노드의 CPU 수를 그대로 인식하는데, 작은 Pod라도 노드가 32코어면 GC worker가 그만큼 만들어질 수 있다
Pod limits와 옵션을 바꿔가며 어떻게 달라지는지 직접 확인해보자. 아래 시뮬레이터는 JDK별 HotSpot 판정 규칙으로 계산한 값이고 실제 JVM 출력은 아닌데, JDK 8, 11, 17, 21은 실제 Pod로 확인한 값과 같게 나온다.
1) 기본 GC = CPU와 메모리
JDK 21 HotSpot은 GC를 지정하지 않으면 server-class machine인지 확인하고, 맞으면 G1GC, 아니면 Serial GC를 고른다.
OpenJDK 21의 os::is_server_class_machine()은 아래 두 조건을 모두 만족할 때 server-class로 판단하는데, 컨테이너 안에서는 여기서 말하는 CPU와 메모리가 cgroup에서 읽은 limits 값이 된다. (Oracle GC Tuning Guide의 Ergonomics에도 같은 기준이 나온다.)
- JVM이 인식한 CPU 2개 이상
- JVM이 인식한 메모리 1792MiB 이상 (구현상 2GiB에서 256MiB 여유를 뺀 값)
둘 다 만족해야 G1이다. Temurin 21.0.10 이미지로 띄운 Pod의 limits를 바꿔가며 java -Xlog:gc -version을 실행한 결과는 아래와 같다.
limits cpu 1, mem 4Gi                              → Using Serial
limits cpu 2, mem 4Gi                              → Using G1
limits cpu 8, mem 1Gi                              → Using Serial
limits cpu 1, mem 1791Mi + -XX:ActiveProcessorCount=2  → Using Serial
limits cpu 1, mem 1792Mi + -XX:ActiveProcessorCount=2  → Using G1
메모리 1MiB 차이로 GC가 바뀌고, CPU가 8개여도 메모리가 1Gi면, 메모리가 4Gi여도 CPU가 1개면 Serial이 선택된다.
이 조건은 G1을 자동으로 고르는 조건일 뿐 G1의 최소 사양은 아니라서, -XX:+UseG1GC를 명시하면 limits cpu 1, mem 1Gi에서도 G1로 실행된다. (JDK 버전이나 배포판에 따라 다를 수 있으니, 사용하는 환경에서 같은 명령으로 확인해보는 게 좋다.)
Q. 다른 JDK 버전에서도 똑같을까?
A.
server-class 판정 기준(CPU 2개, 메모리 1792MiB)은 같은데, 판정 결과로 고르는 GC가 버전마다 다르다.
Temurin 8, 11, 17, 21 Pod에서 -XX:+PrintFlagsFinal로 확인한 결과는 아래와 같다.
| JDK | server-class일 때 | server-class가 아닐 때 | 비고 |
|---|---|---|---|
| 8 | Parallel | Serial | |
| 9 ~ 26 | G1 | Serial | JDK 9부터 G1이 기본 (JEP 248), 11, 17, 21에서 확인 |
| 27 이상 | G1 | G1 | 리소스와 상관없이 항상 G1 (JEP 523) |
(8u504, 11.0.32, 17.0.20, 21.0.12에서 limits cpu 1, 2와 mem 1Gi, 1792Mi, 4Gi를 조합해 확인했고, 최대 Heap과 ParallelGCThreads는 버전과 상관없이 같았다.)
JDK 27 이상에서는 리소스를 줄여도 GC 종류는 바뀌지 않지만, GC worker 수와 Heap 크기는 여전히 리소스를 따라 바뀐다. (Serial은 -XX:+UseSerialGC로 명시하면 계속 쓸 수 있다.)
Q. -server 옵션을 붙이면 server-class가 될까?
A.
64-bit JDK에는 Server VM만 있어서 -server는 이미 기본값이고 -client는 무시되는데, server-class는 VM 종류가 아니라 JVM이 CPU와 메모리를 보고 내리는 판정이라 이 옵션과는 관계가 없다. limits cpu 1, mem 1Gi Pod에서 옵션별로 확인하면 아래와 같다.
| limits cpu 1, mem 1Gi | 옵션 없음 | -server | -client | -XX:+AlwaysActAsServerClassMachine |
|---|---|---|---|---|
| JDK 8 | Serial | Serial | Serial | Parallel |
| JDK 11, 17, 21 | Serial | Serial | Serial | G1 |
판정 자체를 바꾸려면 -XX:+AlwaysActAsServerClassMachine을 줘야 하는데, GC를 바꾸는 게 목적이라면 -XX:+UseG1GC처럼 GC를 직접 지정하는 게 더 명확하다.
2) GC Worker 수 = CPU 수
G1의 ParallelGCThreads는 STW 구간에서 일하는 worker 수, ConcGCThreads는 애플리케이션과 동시에 marking을 하는 worker 수다.
CPU 8개까지 ParallelGCThreads는 CPU 수만큼, ConcGCThreads는 max((ParallelGCThreads + 2) / 4, 1)로 정해지는데, 실제 Pod에서 -XX:+PrintFlagsFinal로 확인한 값은 아래와 같다.
Pod limits (-XX:+UseG1GC) | ParallelGCThreads | ConcGCThreads |
|---|---|---|
| cpu 8, mem 4Gi | 8 | 2 |
| cpu 4, mem 4Gi | 4 | 1 |
| cpu 1, mem 4Gi | 1 | 1 |
cpu 1, mem 1Gi + ActiveProcessorCount=2 | 2 | 1 |
-XX:+UseG1GC로 GC 종류를 고정해도 worker 수는 위와 같이 리소스를 따라간다. (Serial은 원래 단일 스레드 GC라 worker 개념이 없다.)
3) 최대 Heap = 메모리의 25%
-Xmx가 없으면 최대 Heap은 메모리 limit × MaxRAMPercentage(기본 25%)로, mem 4Gi면 1GiB, mem 1Gi면 256MiB다.
즉, 메모리 limit을 1/4로 줄이면 Heap도 1/4로 줄어든다.
앞의 지표에서 변경 후 최대 Heap이 256MiB가 아니라 247.5MiB로 보인 건, jvm_memory_limit_bytes가 메모리 풀별 상한의 합이기 때문이다.
변경 후 Pod(Serial)의 풀별 상한을 Prometheus에서 조회하면 아래와 같다.
메모리 풀 (jvm_memory_pool_name) | 상한 |
|---|---|
| Eden Space | 68.31MiB |
| Survivor Space | 8.5MiB |
| Tenured Gen | 170.69MiB |
| 합계 (지표에 보이는 값) | 247.5MiB |
Serial의 Young 영역은 Eden 하나와 Survivor 두 개(from, to)로 나뉘는데, 한 번에 객체를 담는 Survivor는 하나뿐이라 JVM은 Survivor를 하나만 풀 상한으로 보고한다.
여기에 남은 Survivor 하나(8.5MiB)를 더하면 68.31 + 8.5 × 2 + 170.69 = 256MiB로, -XX:+PrintFlagsFinal로 확인한 MaxHeapSize(268435456 = 256MiB)와 같다.
OTel + Prometheus로 GC 변화 확인
OpenTelemetry Java agent는 별도 코드 없이 JVM 메트릭(CPU 수, Heap, GC 이벤트)을 내보내므로, 리소스 변경 전후를 같은 그래프에서 비교할 수 있다.
App Pod (OTel Java agent) → OTLP → OTel Collector → Prometheus → Grafana
실험은 목적에 따라 아래와 같이 나눠서 진행했는데, 실험마다 집계 구간과 반복 횟수가 달라서 숫자는 같은 실험 안에서만 비교한다.
| 실험 | 목적 | 부하 | 집계 구간 | 반복 | 나오는 곳 |
|---|---|---|---|---|---|
| 리소스 변경 전후 | resources만 바꿨을 때 GC가 바뀌는지 지표로 확인 | 300 RPS | 변경 직전 5분, 변경 후 마지막 5분 (Prometheus) | 1회 | 아래 3) |
| 조건별 비교 | GC 종류, CPU, 메모리 중 무엇 때문에 성능이 달라졌는지 분리 | 300 RPS | 워밍업 1분 제외 3분 (k6, GC 로그) | 조건마다 3회 | Q. GC가 바뀌면 어떻게 될까? |
| 참고. 리소스 변경 전후 (부하 증가) | 부하를 올렸을 때 클라이언트 지연 | 400 RPS | 전체 12분 (k6) | 1회 | 4) 서버 지표만으로는 부족하다 |
1) 실험 환경
| 항목 | 값 |
|---|---|
| 클러스터 | kind v0.32 (Kubernetes v1.36), 단일 노드, Docker Desktop (arm64, cgroup v2) |
| JDK | Temurin 21.0.10+7 (eclipse-temurin:21-jre) |
| 애플리케이션 | Spring Boot 게시글 피드 API(GET /feed). 요청마다 게시글 200개짜리 피드를 만들어 JSON으로 응답하고, 최근 피드 2,000건을 메모리에 캐시 |
| 부하 | k6, 고정 RPS (constant-arrival-rate, preAllocatedVUs 50, maxVUs 400) |
| 수집 | OTel Java agent 2.31.1 → Collector 0.123.0 → Prometheus 3.2.1 → Grafana 10.4.3 |
| Pod requests | 모든 조건에서 cpu 500m, mem은 limit과 같은 값 (JVM은 limits만 보기 때문에 결과에 영향 없음) |
운영이나 기존 클러스터가 아니라, 누구나 같은 조건으로 재현할 수 있도록 로컬의 단일 노드 kind 클러스터에서 실험했다.
단일 노드라 k6, 관측 스택, 애플리케이션이 같은 호스트 CPU를 나눠 쓰는데, 애플리케이션 Pod의 CPU limit은 cgroup으로 강제되지만 호스트 경합까지 통제하지는 않았다.
애플리케이션, Kubernetes 매니페스트, 측정 스크립트와 원본 결과는 let-me-code/jvm-container-gc에 있다.
2) 수집 설정
JVM 옵션에 agent만 추가하고, 메트릭은 OTLP로 Collector에 보낸다.
env:
  - name: JAVA_OPTS
    value: >-
      -javaagent:/otel/agent.jar
      -Xlog:gc*:stdout:time,uptime,level,tags
  - { name: OTEL_SERVICE_NAME, value: app }
  - { name: OTEL_EXPORTER_OTLP_ENDPOINT, value: "http://otel-collector:4318" }
  - { name: OTEL_METRICS_EXPORTER, value: otlp }
  - { name: OTEL_TRACES_EXPORTER, value: none }
  - { name: OTEL_LOGS_EXPORTER, value: none }
  - { name: OTEL_METRIC_EXPORT_INTERVAL, value: "5000" }
Collector는 OTLP로 받은 메트릭을 Prometheus가 수집할 수 있게 노출한다.
exporters:
  prometheus:
    endpoint: 0.0.0.0:8889
    metric_expiration: 15s
    resource_to_telemetry_conversion:
      enabled: true
resource_to_telemetry_conversion을 켜면 service_name, host_name(Pod 이름) 같은 리소스 속성이 Prometheus 라벨로 붙는데, resources를 바꾸면 Deployment가 새 ReplicaSet으로 Pod를 다시 만들기 때문에 host_name으로 변경 전 Pod와 변경 후 Pod를 구분할 수 있다.
3) 리소스를 바꿔보자
300 RPS 부하를 계속 주면서, 6분 뒤에 resources만 limits cpu 8, mem 4Gi에서 limits cpu 1, mem 1Gi로 바꿨다. (메모리 requests도 limits와 같게 4Gi에서 1Gi로 바뀌고, CPU requests는 500m 그대로다)
kubectl set resources deploy/app \
  --requests=cpu=500m,memory=1Gi --limits=cpu=1,memory=1Gi
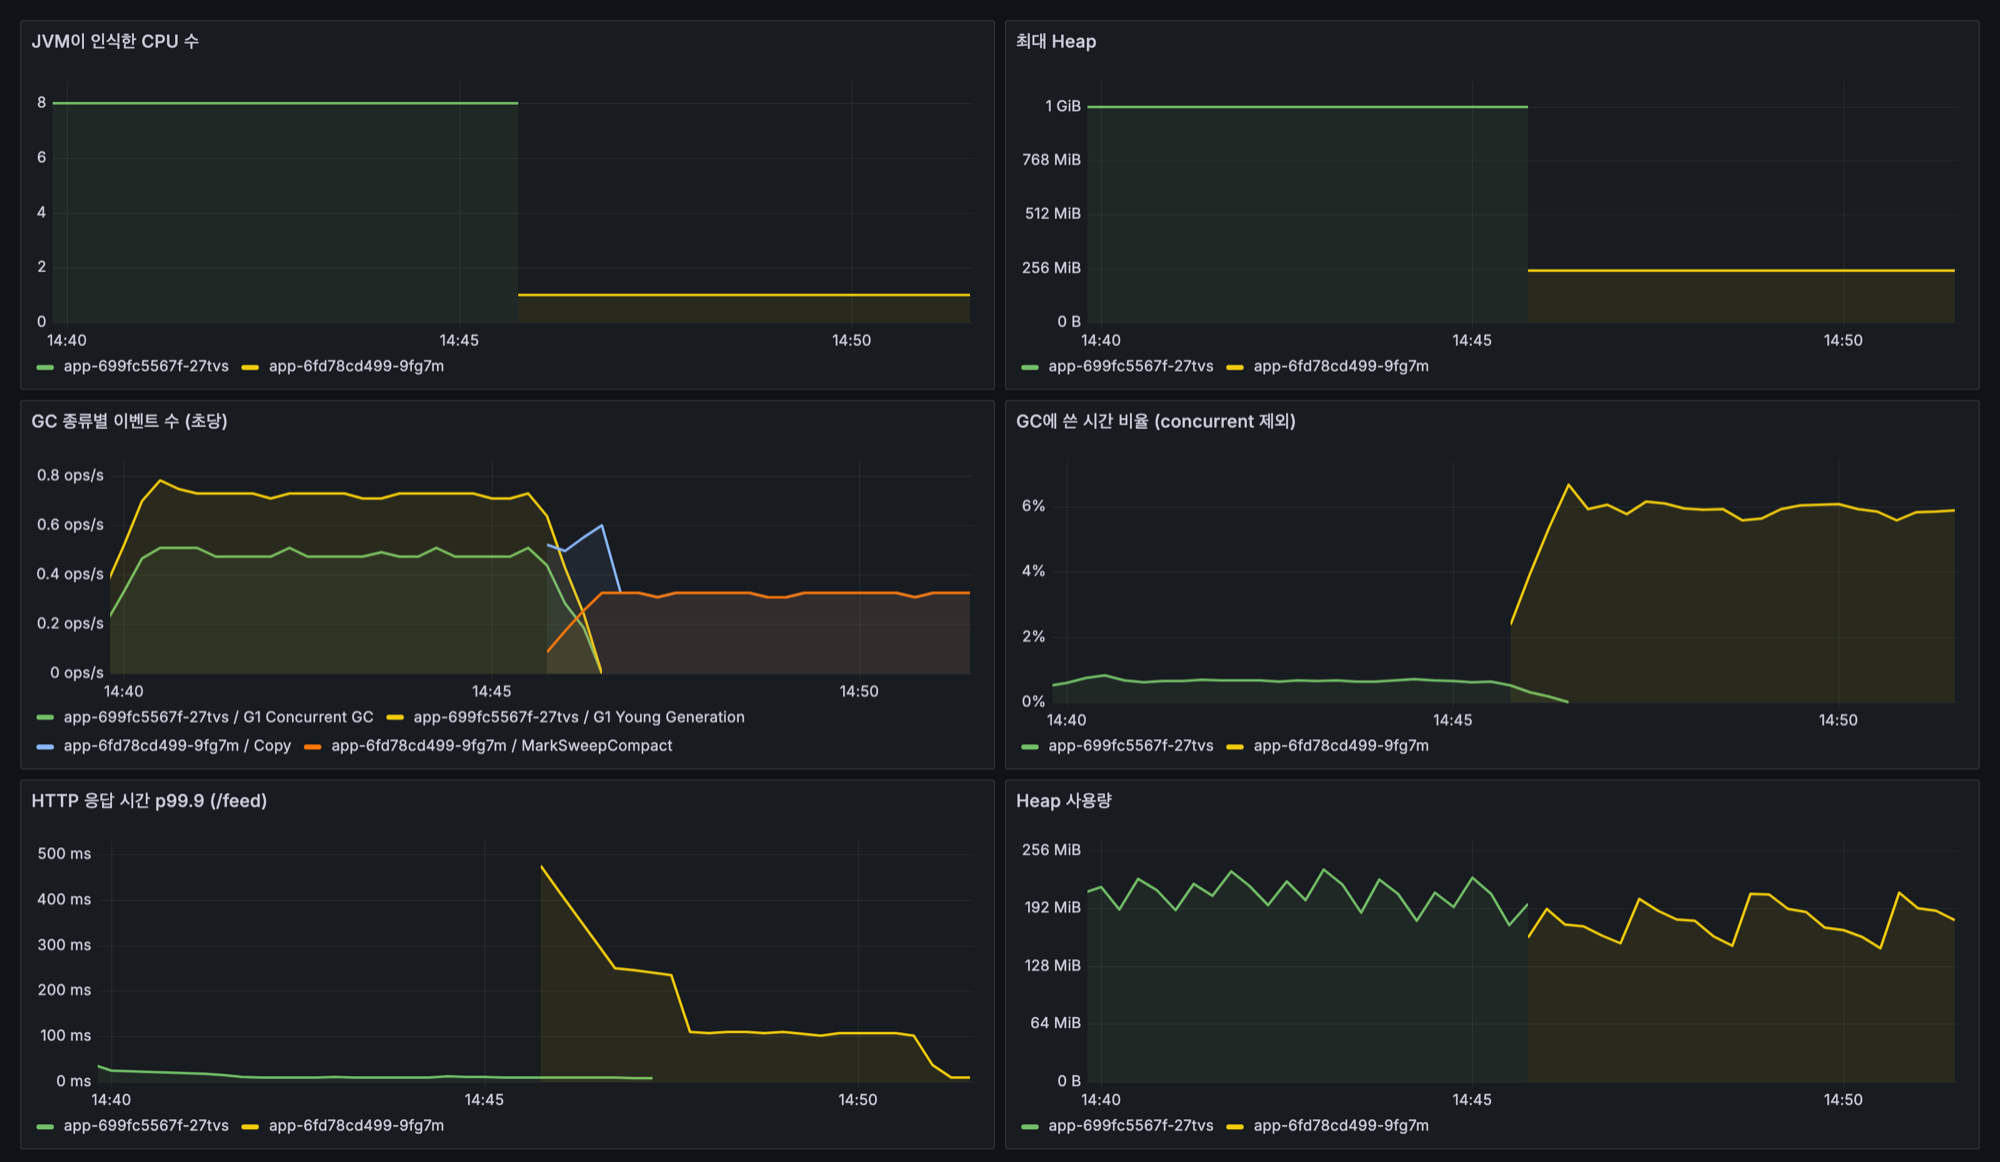
노랑 app-6fd78cd499-9fg7m → 변경 후 Pod (limits cpu 1, mem 1Gi)
최대 Heap은 1GiB에서 256MiB로 줄었는데, 그래프에는 Survivor 하나를 뺀 247.5MiB로 보인다.
아래 값은 300 RPS 시나리오 1회에서, 변경 직전 5분과 변경 후 마지막 5분 구간을 Prometheus로 조회한 값이다.
| 확인할 것 | PromQL | 변경 전 (limits cpu 8, mem 4Gi) | 변경 후 (limits cpu 1, mem 1Gi) |
|---|---|---|---|
| JVM이 인식한 CPU | jvm_cpu_count | 8 | 1 |
| GC 종류 | jvm_gc_duration_seconds_count의 jvm_gc_name | G1 Young Generation | Copy, MarkSweepCompact |
| 최대 Heap | jvm_memory_limit_bytes{jvm_memory_type="heap"} | 1024MiB | 247.5MiB |
| GC에 쓴 시간 비율 | rate(jvm_gc_duration_seconds_sum[5m]) | 0.66% | 5.87% |
| GC 1회 평균 시간 | rate(..._sum[5m]) / rate(..._count[5m]) | 9.1ms | 91ms |
| HTTP 응답 시간 p99.9 | http_server_request_duration_seconds_bucket | 9.9ms | 102.6ms |
GC가 바뀐 건 jvm_gc_name 라벨로 바로 보인다. G1은 G1 Young Generation, G1 Old Generation, G1 Concurrent GC로, Serial은 Copy(Young), MarkSweepCompact(Old)로 수집된다.
대시보드에 쓴 쿼리는 아래와 같다.
# GC 종류별 이벤트 수 (초당)
sum by (host_name, jvm_gc_name) (rate(jvm_gc_duration_seconds_count{service_name="app"}[1m]))

# GC에 쓴 시간 비율 (%). G1 Concurrent GC는 애플리케이션과 동시에 도는 구간이라 제외
100 * sum by (host_name) (
  rate(jvm_gc_duration_seconds_sum{service_name="app", jvm_gc_name!="G1 Concurrent GC"}[1m])
)

# HTTP 응답 시간 p99.9 (ms), Pod별
1000 * histogram_quantile(0.999,
  sum by (le, host_name) (rate(http_server_request_duration_seconds_bucket{service_name="app", http_route="/feed"}[2m]))
)
응답 시간을 p99가 아니라 p99.9로 본 이유는, 99% 이상의 요청이 5ms 안에 끝나서 p99는 OTel histogram의 첫 bucket(0~5ms) 안에서 계산되기 때문이다. Full GC로 늘어나는 지연은 0.1% 정도의 요청에만 나타나서 p99.9에서 드러난다.
Q. 변경 직후 p99.9가 크게 튀는 구간은 뭘까?
A.
Pod별로 30초 단위로 나눠 보면, 새 Pod가 트래픽을 받기 시작한 직후 약 30초 동안 p99.9가 400~456ms까지 오르고 그 뒤로는 약 110ms 수준에서 안정된다.
이 30초 동안은 두 가지가 겹쳐 있다.
- 새 JVM의 JIT 컴파일과 클래스 로딩 때문에 CPU 사용량이 0.5~0.6코어까지 오른다 (limits cpu 1)
- Serial Full GC가 이미 시작된 상태라 GC 시간 비율도 6~7%다
대시보드에서 새 Pod(노랑)의 p99.9가 470ms 근처에서 시작해 약 2분에 걸쳐 내려오는 건 이 30초의 급등이 2분 rate 윈도에 섞인 결과라서, GC의 영향은 워밍업이 끝난 뒤의 약 105ms로 판단하는 게 맞다. (변경 전 Pod(초록)는 종료될 때까지 약 10ms를 유지한다)
Q. GC가 바뀌면 어떻게 될까?
리소스 변경 전후 실험에서는 CPU, 메모리, GC 종류가 한꺼번에 바뀌기 때문에, 무엇 때문에 달라졌는지 나눠 보려고 조건을 하나씩 바꿔서 따로 측정했다. (조건별 비교)
조건마다 Pod를 하나씩만 띄우고 300 RPS로 4분(워밍업 1분 제외, 3분 집계)씩 3회 반복했고, 응답 시간은 k6, GC pause는 GC 로그, CPU throttling은 cgroup cpu.stat에서 집계했다.
| Pod limits, GC | k6 p95 | k6 p99 | Full GC | GC pause p99 | GC 시간 비율 | dropped_iterations |
|---|---|---|---|---|---|---|
| cpu 8, mem 4Gi → 자동 G1 | 1.1ms | 2.9ms | 0회 | 17ms | 0.7% | 0 |
| cpu 1, mem 1Gi → 자동 Serial | 38ms | 160ms | 59회 | 223ms | 6.0% | 24 |
| cpu 1, mem 4Gi + UseG1GC | 1.4ms | 29ms | 0회 | 58ms | 2.8% | 0 |
| cpu 1, mem 1Gi + UseG1GC | 1.6ms | 23ms | 0회 | 41ms | 3.4% | 0 |
| cpu 1, mem 1Gi + UseG1GC + ActiveProcessorCount=2 | 1.3ms | 11ms | 0회 | 28ms | 2.0% | 0 |
3회 반복의 중앙값이고, 3분 동안 300 RPS로 약 54,000건을 호출했다. (p50은 모든 조건에서 0.4~0.5ms로 같다.)
dropped_iterations는 서버가 실패시킨 요청이 아니라, 사용할 수 있는 VU가 없어 k6가 정해진 시각에 보내지 못한 요청 수인데, 응답이 느려져 VU가 오래 묶일수록 늘어난다. (HTTP 실패는 모든 조건에서 0건이었다.)
각 조건의 1회차 측정 구간(워밍업 포함)을 Grafana로 보면 아래와 같고, 탭 이름의 cpu, mem은 모두 limits 값이다.
-
조건
- limits: cpu 8, mem 4Gi / requests: cpu 500m, mem 4Gi
- GC 옵션 없음 → G1 자동 선택 (기준 조건)
-
확인해야 하는 부분
- G1 Young GC가 초당 약 0.7회 발생한다
- GC 시간 비율은 1% 미만으로 낮게 유지된다
- 최대 Heap이 1GiB라 여유가 많다
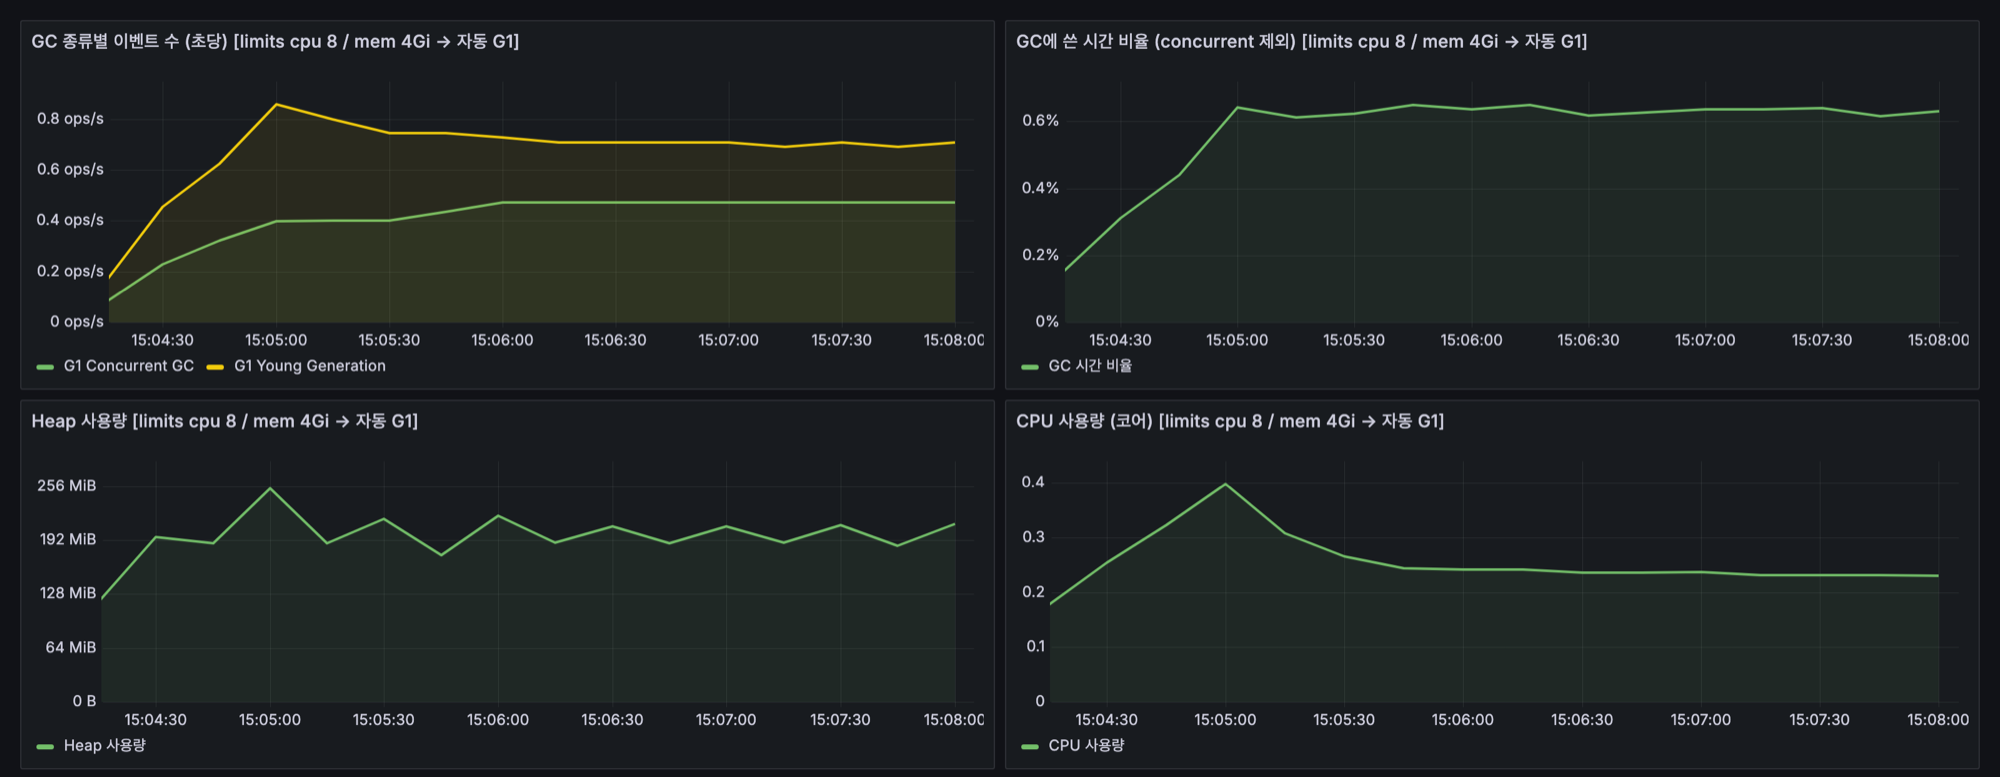
다섯 조건 모두 CPU 사용량은 워밍업이 끝난 뒤 0.2코어 정도로 비슷한데, 300 RPS가 cpu 1에서도 충분히 처리할 수 있는 부하라는 뜻이다.
즉, 아래에서 보이는 차이는 CPU가 모자라서가 아니라 GC 종류와 GC worker 수, Heap 크기가 달라서 생긴 것이다. (그래프마다 y축 범위가 다르니 값을 함께 보자.)
1) Serial은 Full GC가 곧 지연이다
같은 limits cpu 1, mem 1Gi에서 GC를 지정하지 않아 Serial이 선택된 경우와 G1을 명시한 경우를 비교하면 차이가 가장 크다.
| limits cpu 1, mem 1Gi | Serial (자동 선택) | G1 (명시) |
|---|---|---|
| Full GC (3분) | 59회 | 0회 |
| GC pause p99 | 223ms | 41ms |
| k6 p99 | 160ms | 23ms |
| dropped_iterations | 24건 | 0건 |
Serial 탭에서 Copy와 MarkSweepCompact가 같은 빈도로 보였는데, GC 로그로 순서를 확인해보면 아래와 같다.
GC(139) Pause Young (Allocation Failure) 213M->213M(247M)   0.265ms
GC(140) Pause Full  (Allocation Failure) 213M->145M(247M) 255.939ms
GC(141) Pause Young (Allocation Failure) 213M->213M(247M)   0.112ms
GC(142) Pause Full  (Allocation Failure) 213M->153M(247M) 183.427ms
이 애플리케이션은 최근 피드 2,000건을 캐시하고 있어서 살아남는 객체가 계속 Old 영역으로 올라가는데, Young GC가 메모리를 하나도 회수하지 못하고(213M → 213M) 끝난 직후 Heap 전체를 멈추고 정리하는 Full GC가 이어진다.
측정 구간(3분)만 놓고 보면 3회 모두 Young GC 다음에는 예외 없이 Full GC가 이어졌고(1회차 기준 59번 중 59번), 256MiB Heap에서 한 번에 180~255ms가 걸렸다.
G1은 concurrent marking과 Mixed GC로 Old 영역을 나눠서 정리하기 때문에 이번 실험(300 RPS, 3분 x 3회)에서는 Full GC가 한 번도 발생하지 않았는데, 생존 객체가 더 많거나 할당 속도가 더 빠르면 G1도 Full GC가 날 수 있다.
그렇다고 작은 Pod에서 무조건 G1이 좋은 건 아니다. Serial은 GC 스레드가 하나라 CPU와 메모리 오버헤드가 가장 작아서, 생존 객체가 적고 Old 영역으로 넘어가는 객체가 거의 없는 애플리케이션이라면 충분할 수 있다.
이번처럼 캐시나 세션 같은 생존 객체가 계속 쌓이는 애플리케이션이라면 Full GC가 바로 지연으로 이어지므로, 리소스를 줄였을 때 GC가 바뀌는지 확인하고 의도한 GC를 명시해두는 게 안전하다.
2) G1도 CPU가 줄면 pause가 길다
cpu 8, mem 4Gi(자동 G1)와 cpu 1, mem 4Gi(G1 명시)는 둘 다 G1, 최대 Heap 1GiB로 같고 CPU limit만 8에서 1로 다른데, GC worker가 8개에서 1개로 줄면서 GC pause p99가 17ms에서 58ms로 길어지고 k6 p99도 2.9ms에서 29ms가 된다.
여기서 메모리 limit까지 1Gi로 줄이면(cpu 1, mem 1Gi, G1 명시) Heap이 256MiB가 되면서 G1 Young GC가 초당 0.54회에서 1.08회로 두 배가 되지만, 한 번에 처리하는 Heap이 작아서 p99는 23ms로 비슷하다.
즉, G1을 유지하더라도 CPU를 줄이면 GC worker 수가 줄어 pause가 길어지고, 메모리를 줄이면 GC가 더 자주 일어난다.
3) ActiveProcessorCount는 CPU 여유가 있어야 효과가 있다
CPU limit은 1 그대로 두고 -XX:ActiveProcessorCount=2만 추가하면 ParallelGCThreads가 1에서 2가 된다.
| limits cpu 1, mem 1Gi, G1 명시 | 기본 | + ActiveProcessorCount=2 |
|---|---|---|
| ParallelGCThreads | 1 | 2 |
| GC pause p99 | 41ms | 28ms |
| k6 p99 | 23ms | 11ms |
| 평균 CPU 사용량 | 0.21코어 | 0.22코어 |
| throttling 발생 시간 (3분) | 0.43초 | 0.96초 |
이번 측정에서는 3회 모두 p99가 절반 정도로 줄었는데, Grafana를 보면 GC 횟수와 CPU 사용량은 두 조건이 거의 같고 GC 시간 비율만 약 3%에서 약 1.7%로 내려간다.
CPU 시간이 늘어난 게 아니라 같은 GC 작업을 worker 2개가 나눠 처리해서 pause가 짧아진 것으로 보이는데, 이게 가능했던 건 CPU quota에 여유가 있었기 때문이다.
CPU limit 1은 100ms마다 CPU 시간 100ms를 쓸 수 있다는 뜻이라서, 애플리케이션이 평균 0.2코어만 쓰고 있으면 GC 순간에 worker 2개가 동시에 돌아도 대부분은 quota 안에서 처리된다.
대신 worker 2개가 동시에 돌면 그만큼 quota를 더 빨리 소진하기 때문에, 이번 실험에서도 throttling 시간이 0.43초에서 0.96초로 두 배 넘게 늘었다. pause는 짧아졌지만 throttling 위험은 커진 셈이다.
애플리케이션이 CPU를 거의 다 쓰고 있다면 worker를 늘려도 quota를 나눠 쓸 뿐이라, pause가 줄기보다 throttling이 먼저 늘어날 가능성이 크다.
또 ActiveProcessorCount는 GC뿐 아니라 availableProcessors()로 크기를 정하는 곳에도 그대로 적용되는데, ForkJoinPool.commonPool()(parallel stream, CompletableFuture 기본 실행기), Netty 이벤트 루프, 비동기 라이브러리의 기본 스레드 수가 함께 늘어나 같은 CPU quota 안에서 컨텍스트 스위칭과 throttling이 커질 수 있다.
그래서 CPU에 여유가 있는 서비스에서 측정해보고 적용하는 옵션이지, CPU를 줄인 만큼을 채워주는 옵션은 아니다.
4) 서버 지표만으로는 부족하다
리소스 변경 전후 실험의 부하를 400 RPS로 올려 한 번 더 돌려보면, 변경 후 Full GC(MarkSweepCompact)가 약 2초마다 발생하고 GC 시간 비율은 0.77%에서 8.28%까지 올라간다.
아래 k6 값은 변경 전후를 나누지 않은 전체 12분 구간을 1회 측정한 값이라, 조건별 비교 표(워밍업 제외 3분, 3회 중앙값)와 숫자를 직접 비교하지는 않는다.
| k6 (클라이언트 기준, 전체 12분 1회) | p95 | p99 | max | dropped_iterations | HTTP 실패 |
|---|---|---|---|---|---|
| 300 RPS | 2.0ms | 136ms | 405ms | 74건 | 39건 |
| 400 RPS | 33ms | 230ms | 3.4초 | 337건 | 68건 |
300 RPS인 리소스 변경 전후 실험에서 서버 지표(OTel)의 p99.9는 약 105ms였는데, 클라이언트(k6)의 max는 405ms까지 나온다.
GC pause가 어느 시점에 걸리느냐에 따라 서버 지표에 반영되는 정도가 다르기 때문이다.
- 요청을 처리하는 도중에 STW pause가 걸리면, 그 시간은 http.server.request.duration에 그대로 포함된다
- 요청이 계측이 시작되기 전에 커넥션 accept 대기열이나 Tomcat 작업 큐에서 기다리는 동안 pause가 걸리면, 그 대기 시간은 서버 지표에 잡히지 않는다
Full GC가 200ms 가까이 걸리면 그동안 들어온 요청이 계측 시작 전 단계에 쌓이기 때문에, 서버 지표만 보면 GC의 영향을 작게 보게 될 수 있고 클라이언트(호출하는 쪽)의 응답 시간도 함께 확인해야 한다.
Tips) Pod에서 확인하는 방법
리소스를 바꿨다면 JVM이 무엇을 인식했는지 확인해두자. 방법별로 필요한 설정과 확인할 수 있는 것을 정리하면 아래와 같다.
| 방법 | 별도 설정 | 확인할 수 있는 것 |
|---|---|---|
| 1) JVM 지표 (OTel, Micrometer 등) | 메트릭 수집 구성 | GC 종류, CPU 수, Heap, GC 시간 |
2) 같은 Pod에서 java -version 실행 | 없음 | GC 종류, CPU/메모리 인식값, 최종 플래그 |
3) jcmd 1 VM.flags | JDK 이미지 (JRE에는 없음) | 실행 중인 JVM의 최종 플래그 |
4) GC 시작 로그 (-Xlog:gc+init) | JVM 옵션 또는 JAVA_TOOL_OPTIONS | GC 종류, Heap, CPU 수 |
5) cgroup cpu.max, cpu.stat | 없음 | CPU limit, throttling 횟수와 시간 |
아래 출력은 모두 limits cpu 1, mem 1Gi로 띄운 같은 Pod(app-6fd78cd499-7hk88)에서 300 RPS 부하를 준 뒤 실행한 결과다.
1) JVM 지표
지표를 수집하고 있다면 Pod별로 jvm_gc_name 라벨만 봐도 어떤 GC가 쓰이는지 알 수 있는데, 같은 Pod의 CPU 수와 최대 Heap까지 조회하면 아래와 같다.
count by (host_name, jvm_gc_name) (jvm_gc_duration_seconds_count)
max by (host_name) (jvm_cpu_count)
sum by (host_name) (jvm_memory_limit_bytes{jvm_memory_type="heap"})
{host_name="app-6fd78cd499-7hk88", jvm_gc_name="Copy"}              1
{host_name="app-6fd78cd499-7hk88", jvm_gc_name="MarkSweepCompact"}  1
{host_name="app-6fd78cd499-7hk88"}                                  1           # jvm_cpu_count
{host_name="app-6fd78cd499-7hk88"}                                  259522560   # 247.5MiB
Micrometer(Spring Boot Actuator)를 쓴다면 jvm_gc_pause_seconds_count의 gc 라벨, system_cpu_count로 같은 내용을 볼 수 있다.
2) 같은 Pod에 JVM 하나 더 띄우기
지표를 수집하지 않는 환경이라면 가장 간단한 방법인데, 실행 중인 애플리케이션을 건드리지 않고 같은 cgroup 안에서 java -version을 한 번 더 실행하면 된다.
kubectl exec <pod> -- java -Xlog:os+container=trace -Xlog:gc -version
[0.001s][debug][os,container] Detected cgroups v2 unified hierarchy
[0.001s][trace][os,container] CPU Quota is: 100000
[0.001s][trace][os,container] CPU Period is: 100000
[0.001s][trace][os,container] OSContainer::active_processor_count: 1
[0.001s][trace][os,container] Memory Limit is: 1073741824
[0.002s][info ][gc          ] Using Serial
openjdk version "21.0.10" 2026-01-20 LTS
-XX:+PrintFlagsFinal을 붙이면 ergonomics가 정한 최종값을 볼 수 있는데, 끝에 {ergonomic}이 붙은 값이 JVM이 리소스를 보고 스스로 정한 값이다.
kubectl exec <pod> -- sh -c 'java -XX:+PrintFlagsFinal -version | grep -E " (UseG1GC|UseSerialGC|MaxHeapSize|ParallelGCThreads) "'
   size_t MaxHeapSize                              = 268435456                                 {product} {ergonomic}
     uint ParallelGCThreads                        = 0                                         {product} {default}
     bool UseG1GC                                  = false                                     {product} {default}
     bool UseSerialGC                              = true                                      {product} {ergonomic}
새로 띄운 JVM의 판단이므로 애플리케이션과 같은 JVM 옵션을 붙여서 확인해야 한다. (Serial은 단일 스레드 GC라 ParallelGCThreads는 0으로 남는다.)
3) jcmd로 실행 중인 JVM 확인
2)는 새로 띄운 JVM을 보는 것이라, 지금 떠 있는 애플리케이션 JVM의 값을 직접 보려면 jcmd를 쓴다. JRE 이미지에는 jcmd가 없어서, JDK 이미지로 디버그 컨테이너를 붙여서 실행했다.
kubectl debug <pod> --profile=general --target=app --image=eclipse-temurin:21-jdk -c jdk -- sleep 3600
kubectl exec <pod> -c jdk -- jcmd 1 VM.flags
1:
-XX:CICompilerCount=2 -XX:InitialHeapSize=16777216 -XX:MaxHeapSize=268435456 -XX:MaxNewSize=89456640
-XX:MinHeapDeltaBytes=196608 -XX:MinHeapSize=8388608 -XX:NewSize=5570560 ... -XX:+UseSerialGC
--target으로 애플리케이션 컨테이너의 프로세스 네임스페이스를 공유하기 때문에 PID 1이 애플리케이션 JVM이다.
4) GC 시작 로그
JVM 옵션에 -Xlog:gc+init(또는 -Xlog:gc*)을 넣어두면 시작할 때 인식한 CPU, 메모리와 Heap 크기가 Pod 로그에 남는다. 이번 실험의 Pod는 -Xlog:gc*를 켜두었는데, 시작 로그만 골라보면 아래와 같다.
kubectl logs <pod> | grep 'gc,init'
[0.006s][info][gc,init] Version: 21.0.10+7-LTS (release)
[0.006s][info][gc,init] CPUs: 10 total, 1 available
[0.006s][info][gc,init] Memory: 1024M
[0.006s][info][gc,init] Heap Min Capacity: 8M
[0.006s][info][gc,init] Heap Initial Capacity: 16M
[0.006s][info][gc,init] Heap Max Capacity: 256M
CPUs: 10 total, 1 available은 노드에는 CPU가 10개 있지만 limits 때문에 1개만 쓴다는 뜻이다. 이미지를 다시 만들지 않고 옵션을 넣고 싶다면 JAVA_TOOL_OPTIONS 환경 변수를 쓰면 된다.
5) cgroup으로 CPU limit, throttling 확인
JVM과 별개로, 컨테이너의 cgroup 파일을 보면 실제 CPU limit과 throttling 여부를 알 수 있다.
kubectl exec <pod> -- cat /sys/fs/cgroup/cpu.max /sys/fs/cgroup/cpu.stat
100000 100000
usage_usec 9675064
nr_periods 442
nr_throttled 86
throttled_usec 7734804
cpu.max의 100000 100000은 100ms마다 100ms만큼 쓸 수 있다는 뜻으로 CPU 1개에 해당하고, cpu.stat을 보면 442번의 주기 중 86번 throttling이 걸려 합계 약 7.7초 동안 멈췄다. 이 값은 Pod가 뜬 뒤 누적값이라서, 구간별로 보려면 두 시점의 차이를 계산해야 한다.
정리
Pod 리소스를 줄이기 전에 이것만은 확인해보자.
- 지금 GC가 ergonomics로 정해진 건지, 옵션으로 명시한 건지
- 줄인 메모리 limit에서 Heap이 얼마가 되는지, 그 Heap이 생존 객체를 충분히 담을 수 있는지
- CPU limit 아래에서 throttling이 얼마나 생기는지
availableProcessors()로 크기를 정하는 스레드 풀(ForkJoinPool, Netty event loop 등)이 함께 바뀌는지
📚 Reference
JVM과 컨테이너
- Oracle - HotSpot GC Tuning Guide: Ergonomics (JDK 25)
- JEP 248 - Make G1 the Default Garbage Collector (JDK 9)
- JEP 523 - Make G1 the Default Garbage Collector in All Environments (JDK 27)
- JDK-8146115 - Improve docker container detection and resource configuration usage
- JDK-8230305 - Cgroups v2: Container awareness
- Java 21 - JVM 옵션
- OpenJDK 21 - GC 선택 구현
- OpenJDK 21 - server-class 판정
- OpenJDK 21 - G1 worker 초기화
- Kubernetes - 컨테이너 리소스 관리
- Microsoft Learn - Containerize your Java Applications
- Red Hat - Best practices for Java in single-core containers
- Red Hat - OpenJDK 컨테이너 인식과 버전별 차이
- Linux kernel - cgroup v2 CPU 컨트롤러
메트릭 수집
- OpenTelemetry - Java agent 설정
- OpenTelemetry - JVM 메트릭 Semantic Conventions
- Collector - Prometheus exporter
관련 글